 HopBase
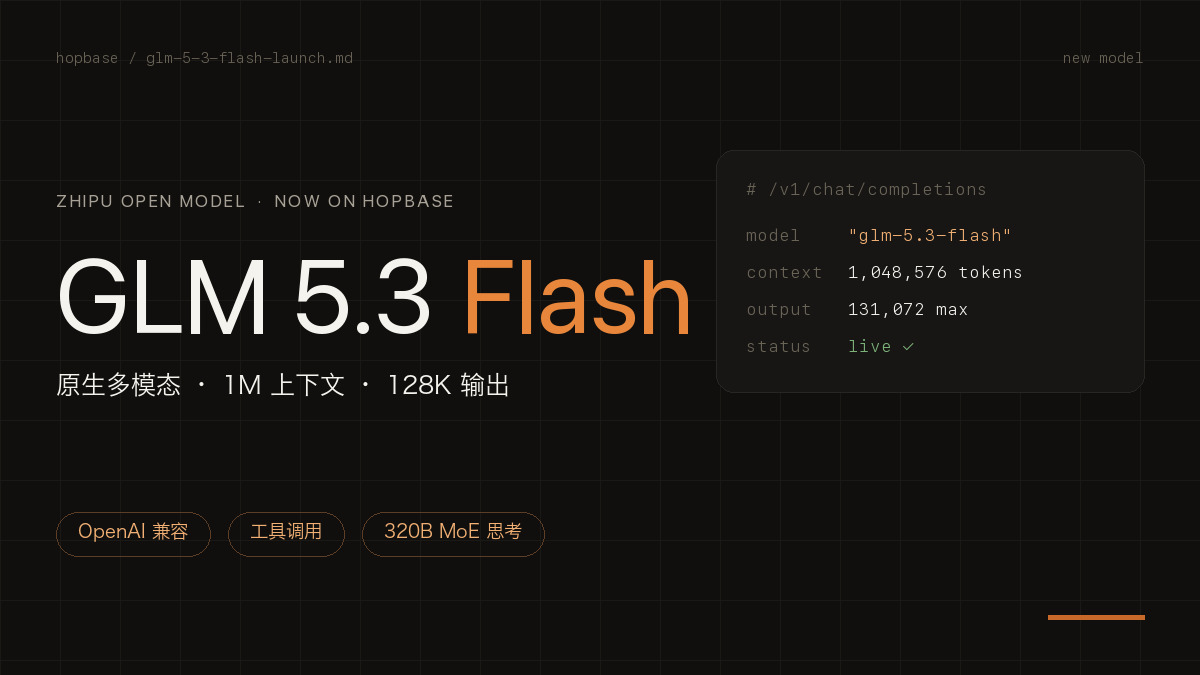
智谱 GLM-5.3-Flash(模型 ID glm-5.3-flash)已经上线 HopBase,走 OpenAI 兼容的 POST /v1/chat/completions,任何 OpenAI SDK 换个模型名就能调。它是 320B 总参、每 token 激活 18B 的 MoE 模型,也是 GLM-5 系列首个原生多模态成员:输入支持文本、图像、视频与文件,输出文本;上下文 1M,单次最多 128K 输出,思考过程在 reasoning_content 返回。计费按智谱官方牌价:每百万 token 输入 ¥0.80、缓存命中 ¥0.23、输出 ¥2.80,是 GLM-5.3 官方定价的十分之一。绑定「GLM 5.3 Flash 专线」分组的密钥即刻可用。
怎么调用
- OpenAI 兼容单端点:
POST /v1/chat/completions,Base URL 为https://api.hop-base.com/v1,SDK 零改造。 - 模型 ID 写全:
glm-5.3-flash。裸名或自己缩写调不通,完整 ID 以GET /v1/models返回为准。 - 分组绑定:该模型放在「GLM 5.3 Flash 专线」套餐分组,绑定该分组的密钥才调得到;GLM-5.3 的密钥不共用。
- 思考过程单独字段:推理内容走
reasoning_content,正文在content,两者分开,前端不必自己切分。
价格:按官方牌价接入
| 项目(每百万 token) | GLM-5.3-Flash |
|---|---|
| 输入 | ¥0.80 |
| 缓存命中读取 | ¥0.23 |
| 输出 | ¥2.80 |
这是智谱公布的官方牌价,官方定价口径为 GLM-5.3 的十分之一。结算按「牌价 × 实际用量」,控制台按请求给出分项成本,实际单价以你所在分组为准。缓存命中读取不到输入价的三分之一,反复读同一前缀的 Agent 循环与长会话省得最多。企业用量请通过价格页联系商务报价。
规格与实测
- 上下文与输出:1M 上下文,单次最多 128K 输出 token。
- 原生多模态输入:文本、图像、视频、文件,输出为文本。
- 架构:混合稀疏与线性注意力。按智谱官方数据,相对 GLM-5.3 注意力计算减少 3.01 倍、KV 缓存减少 4.44 倍,这也是它能把价格压到十分之一的底气。
- 我方实测通过:非流式、流式(
stream_options.include_usage能正常拿到 usage)、函数调用(tool_calls结构完整)、reasoning_content思考过程,四项都在生产链路上跑过。
参数建议
- 官方推荐
temperature: 1、top_p: 0.95、reasoning_effort: "max",不要照搬其它模型的低温度习惯。 - 思考模式只支持开启:没有关闭思考的开关,需要短回复就用提示词和
max_tokens控制。 - 流式场景建议同时开
stream: true与tool_stream: true;要在流式里拿 usage,记得带stream_options: {"include_usage": true}。
三分钟接入
curl https://api.hop-base.com/v1/chat/completions \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{"role": "user", "content": "用三句话介绍你自己"}],
    "temperature": 1,
    "top_p": 0.95,
    "stream": true,
    "stream_options": {"include_usage": true}
}'完整接入说明、工具调用与多模态示例见GLM-5.3-Flash 接入文档。已有密钥的用户把分组绑定到「GLM 5.3 Flash 专线」即可开始用。
常见问题
GLM-5.3-Flash 怎么调用?
走 OpenAI 兼容端点 POST https://api.hop-base.com/v1/chat/completions,模型 ID 填 glm-5.3-flash,任何 OpenAI SDK 换个模型名即可,不用改认证方式。前提是密钥绑定了「GLM 5.3 Flash 专线」分组;完整可用模型清单以 GET /v1/models 返回为准。
GLM-5.3-Flash 的价格是多少?
按智谱官方牌价接入:每百万 token 输入 ¥0.80、缓存命中读取 ¥0.23、输出 ¥2.80,官方定价口径为 GLM-5.3 的十分之一。结算按牌价乘实际用量,控制台按请求给出分项成本,实际单价以所在分组为准。企业用量可通过价格页联系商务报价。
支持多模态和工具调用吗?
支持。它是 GLM-5 系列首个原生多模态成员,输入接受文本、图像、视频与文件,输出为文本。函数调用(tools / tool_calls)在我方生产链路实测通过;流式建议同时开 tool_stream: true,思考过程在 reasoning_content 字段返回。
和 GLM-5.3 怎么选?
两者都是 1M 上下文。Flash 的官方定价是 GLM-5.3 的十分之一,日常对话、Agent 循环、长上下文批量处理这类量大的负载优先用 Flash;需要 GLM-5.3 既有效果基线的存量业务可以继续用原模型,两者是不同的套餐分组,密钥不共用,可以并行接入按实际效果切流。
最大能输出多少 token?
单次最多 128K 输出 token,上下文窗口 1M。长输出建议用流式,避免长连接被边缘超时掐断;要在流式里拿到 usage 统计,请求里带上 stream_options: {"include_usage": true}。