 HopBase
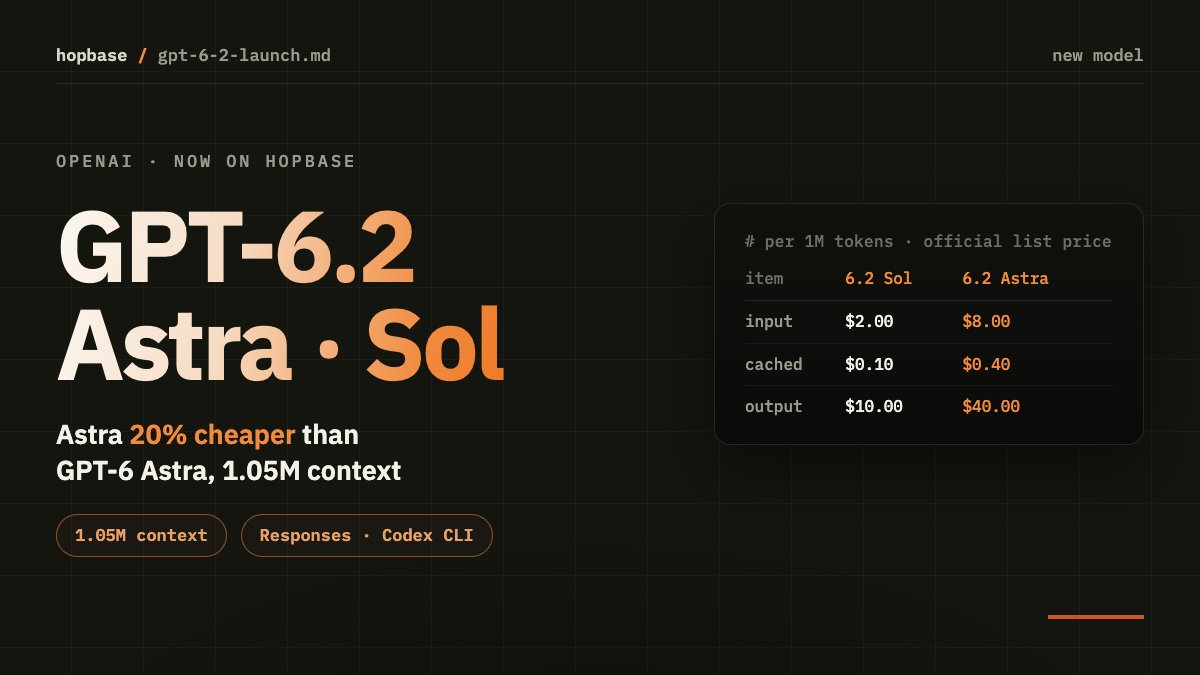
GPT-6.2 Astra (gpt-6.2-astra) y GPT-6.2 Sol (gpt-6.2-sol), publicados por OpenAI el 2026-11-17, ya están disponibles en HopBase en los grupos Codex Plus y Codex Pro. Ambos funcionan con los endpoints compatibles con OpenAI POST /v1/responses y POST /v1/chat/completions, y Codex CLI y la app de Codex pueden usarlos directamente. Cada uno ofrece una ventana de contexto de 1.05 M tokens y hasta 128K tokens de salida. Se facturan al precio de lista oficial de OpenAI: GPT-6.2 Sol cuesta $2 de entrada, $0.10 de entrada en caché y $10 de salida por millón de tokens; GPT-6.2 Astra cuesta $8, $0.40 y $40, un 20 % menos que GPT-6 Astra ($10 / $1 / $50) en entrada y salida, y un 60 % menos en lecturas de caché. Cuando la entrada de una solicitud supera los 272K tokens, la entrada y la caché se facturan a 2x y la salida a 1.5x.
Actualizado el 2026-11-19: precios verificados con la página oficial de precios de OpenAI; endpoints y especificaciones comprobados en la pasarela de producción de HopBase.
En marcha en tres minutos: regístrese en la consola de HopBase, cree una clave, añádale el grupo Codex Plus o Codex Pro, use la Base URL https://api.hop-base.com/v1 y el modelo gpt-6.2-sol o gpt-6.2-astra.
Astra o Sol: cuál elegir
- GPT-6.2 Sol es el modelo principal para programación diaria, agentes y llamadas a herramientas. Cuesta lo mismo que GPT-6.1 Sol ($2 / $10), y su lectura de caché de $0.10 es la mitad que la de GPT-6 Sol ($0.20), algo que se nota en sesiones largas de agentes que reenvían el mismo contexto.
- GPT-6.2 Astra es el nivel insignia para razonamiento difícil y revisión de código, cuando importa acertar a la primera. Cuesta 4 veces más que Sol por token, pero un 20 % menos que el anterior insignia, GPT-6 Astra.
- Una división práctica: construya el flujo con Sol y envíe a Astra solo los pasos de revisión y depuración difícil.
Precios (lista oficial, por 1M de tokens)
| Concepto | GPT-6.2 Sol | GPT-6.2 Astra | GPT-6 Astra (referencia) |
|---|---|---|---|
| Entrada | $2 | $8 | $10 |
| Entrada en caché | $0.10 | $0.40 | $1 |
| Salida | $10 | $40 | $50 |
| Entrada superior a 272K | Entrada y caché ×2, salida ×1.5 (toda la solicitud) | ||
Se factura precio de lista × uso real; la tarifa efectiva depende de su grupo. Consulte la página de precios.
Cómo llamarlo
- Base URL:
https://api.hop-base.com/v1con autenticación Bearer. Con el SDK de OpenAI solo cambia la Base URL y la clave de API. - Endpoints:
POST /v1/responses(recomendado y predeterminado en las herramientas de Codex) yPOST /v1/chat/completions. - Grupos: disponible en Codex Plus y Codex Pro. El grupo GPT oficial directo (Azure) todavía no ofrece GPT-6.2.
- Esfuerzo de razonamiento:
reasoning_effort(reasoning.efforten Responses) funcionó en producción el día del lanzamiento con high, xhigh y max.
curl https://api.hop-base.com/v1/responses \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6.2-sol",
    "input": "Explica la idempotencia en tres frases",
    "stream": true
  }'
from openai import OpenAI
client = OpenAI(base_url="https://api.hop-base.com/v1", api_key="sk-your-key")
resp = client.chat.completions.create(
model="gpt-6.2-astra",
messages=[{"role": "user", "content": "Revisa este código en busca de errores de concurrencia: ..."}],
)
print(resp.choices[0].message.content)Codex CLI y la app de Codex
~/.codex/config.toml:
model_provider = "hopbase"
model = "gpt-6.2-sol"
model_reasoning_effort = "high"

[model_providers.hopbase]
name = "HopBase"
base_url = "https://api.hop-base.com/v1"
wire_api = "responses"
requires_openai_auth = true
Escriba {"OPENAI_API_KEY": "sk-your-key"} en ~/.codex/auth.json. Los pasos completos están en la guía de Codex CLI.
Lo que vimos el día del lanzamiento
- Use streaming. Ambos modelos razonan antes de responder, así que con esfuerzo de razonamiento alto el primer token suele tardar diez segundos o más. En llamadas sin streaming, configure el tiempo de espera del cliente en al menos 300 segundos.
- El contexto largo funciona. Solicitudes de producción con más de 300K tokens de entrada se completaron correctamente; la parte que supera 272K se factura a la tarifa de contexto largo indicada arriba.
- La caché es automática. Las solicitudes de varios turnos que comparten prefijo aciertan en caché y se facturan a $0.10 (Sol) o $0.40 (Astra) por millón de tokens en caché.
Especificaciones completas: documentación de GPT-6.2 Sol y documentación de GPT-6.2 Astra.
Preguntas frecuentes
¿Cuánto cuesta la API de GPT-6.2?
Al precio de lista de OpenAI, GPT-6.2 Sol cuesta $2 de entrada, $0.10 en caché y $10 de salida por millón de tokens; GPT-6.2 Astra cuesta $8, $0.40 y $40. Si la entrada de una solicitud supera los 272K tokens, la entrada se factura a 2x y la salida a 1.5x.
¿En qué se diferencia GPT-6.2 de GPT-6.1?
GPT-6.2 Sol tiene el mismo precio de lista que GPT-6.1 Sol. GPT-6.2 añade el nivel insignia Astra, un 20 % más barato que GPT-6 Astra. Ambas generaciones tienen contexto de 1.05 M y hasta 128K tokens de salida.
¿Puedo usar GPT-6.2 en Codex CLI?
Sí. En config.toml, apunte el proveedor a https://api.hop-base.com/v1 con wire_api = "responses" y use el modelo gpt-6.2-sol o gpt-6.2-astra. Su clave debe incluir el grupo Codex Plus o Codex Pro.
¿Qué significa 404 model_not_found?
Los grupos de su clave no incluyen el modelo. Añada Codex Plus o Codex Pro a la clave en la consola y confírmelo con GET /v1/models.