 HopBase
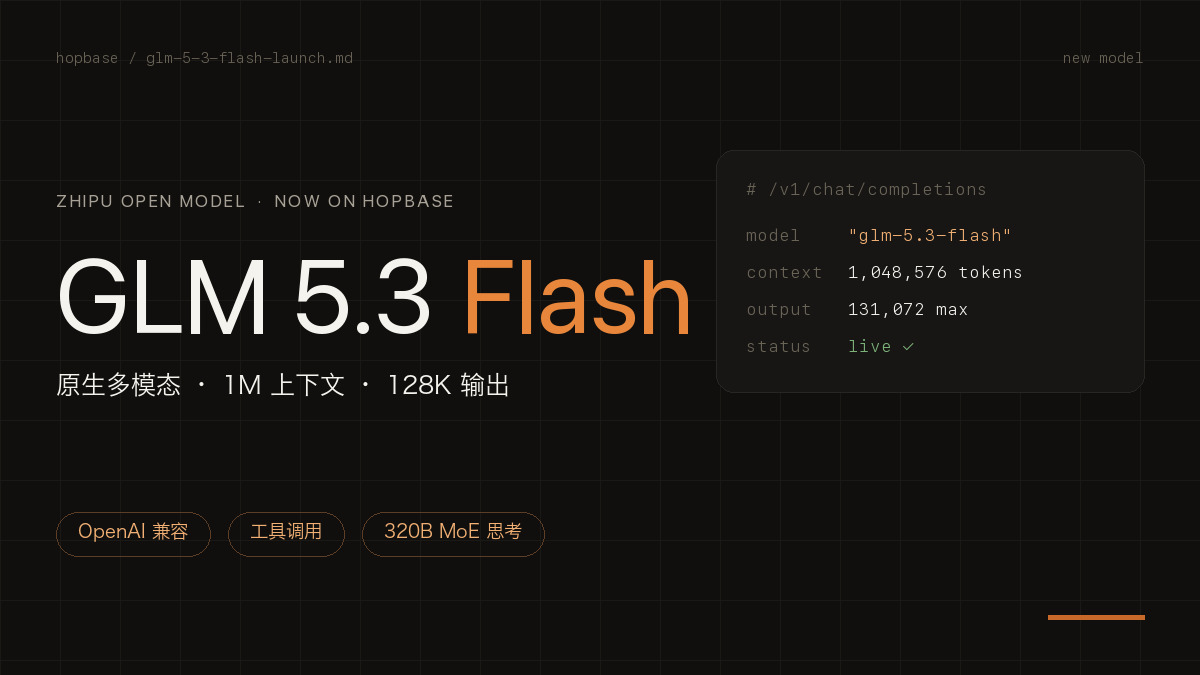
GLM-5.3-Flash de Zhipu (ID de modelo glm-5.3-flash) ya está disponible en HopBase, a través del endpoint compatible con OpenAI POST /v1/chat/completions, por lo que cualquier SDK de OpenAI funciona con solo cambiar el nombre del modelo. Es un modelo Mixture-of-Experts de 320B parámetros que activa 18B parámetros por token, y el primer miembro nativamente multimodal de la familia GLM-5: acepta texto, imágenes, video y archivos como entrada y devuelve texto. La ventana de contexto es de 1M tokens, con hasta 128K tokens de salida en una sola respuesta, y la traza de razonamiento llega en un campo aparte, reasoning_content. HopBase lo factura según el precio de lista oficial internacional de Zhipu (Z.ai): $0.15 por millón de tokens de entrada, $0.03 por millón de tokens de entrada en caché y $0.50 por millón de tokens de salida, aproximadamente una décima parte del precio oficial de GLM-5.3. Cualquier clave cuyos grupos lo incluyan puede invocarlo hoy mismo; GET /v1/models muestra a qué puede acceder su clave.
Cómo invocarlo
- Un único endpoint compatible con OpenAI:
POST /v1/chat/completionscon la base URLhttps://api.hop-base.com/v1. Sin cambios en el SDK. - Use el ID de modelo completo:
glm-5.3-flash. Los nombres abreviados no se resuelven; consulte la lista de referencia enGET /v1/models. - Acceso: su clave necesita un grupo que incluya
glm-5.3-flash; si no aparece enGET /v1/models, añada un grupo así a la clave en la consola. - Razonamiento en su propio campo: la traza de pensamiento se devuelve en
reasoning_contenty la respuesta encontent, así que su cliente no tiene que separarlas.
Precios: al precio de lista oficial
| Por millón de tokens | GLM-5.3-Flash |
|---|---|
| Entrada | $0.15 |
| Lectura de entrada en caché | $0.03 |
| Salida | $0.50 |
Estos son los precios de lista publicados por Zhipu; el precio oficial es aproximadamente una décima parte del de GLM-5.3. Los cargos son el precio de lista por el uso real, detallados por solicitud en la consola, y su precio unitario efectivo depende del grupo de su plan. Las lecturas en caché cuestan menos de un tercio del precio de entrada, por lo que los bucles de agentes y las conversaciones largas que releen el mismo prefijo son los que más ahorran. Para volumen empresarial, contacte con ventas desde la página de precios.
Especificaciones y lo que verificamos
- Contexto y salida: ventana de contexto de 1M, hasta 128K tokens de salida por respuesta.
- Entrada multimodal nativa: entrada de texto, imágenes, video y archivos; salida de texto.
- Arquitectura: atención híbrida dispersa y lineal. Según las cifras de la propia Zhipu, reduce el cómputo de atención 3.01x y la caché KV 4.44x frente a GLM-5.3, lo que hace posible un precio de aproximadamente una décima parte.
- Verificado en nuestra ruta de producción: sin streaming, con streaming (el uso llega con
stream_options.include_usage), llamadas a funciones (tool_callsllega intacto) y la traza de pensamientoreasoning_content.
Recomendaciones de parámetros
- Zhipu recomienda
temperature: 1,top_p: 0.95yreasoning_effort: "max". No traslade los valores predeterminados de temperatura baja que use con otros modelos. - El modo de pensamiento siempre está activo: no hay forma de desactivarlo, así que controle la longitud de la respuesta con su prompt y con
max_tokens. - Para streaming, active tanto
stream: truecomotool_stream: true; añadastream_options: {"include_usage": true}si necesita el uso en el flujo.
Integración en tres minutos
curl https://api.hop-base.com/v1/chat/completions \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{"role": "user", "content": "Introduce yourself in three sentences"}],
    "temperature": 1,
    "top_p": 0.95,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
Las notas completas de integración, las llamadas a herramientas y los ejemplos multimodales están en la guía de integración de GLM-5.3-Flash. Si ya tiene una clave, revise GET /v1/models; si falta glm-5.3-flash, añada a la clave en la consola un grupo que lo incluya y empiece a hacer llamadas.
Preguntas frecuentes
¿Cómo invoco GLM-5.3-Flash?
Envíe una solicitud compatible con OpenAI a POST https://api.hop-base.com/v1/chat/completions con el ID de modelo glm-5.3-flash. Cualquier SDK de OpenAI funciona con solo cambiar el nombre del modelo; la autenticación no cambia. Su clave necesita un grupo que incluya el modelo, y GET /v1/models es la lista de referencia de lo que esa clave puede usar.
¿Cuánto cuesta GLM-5.3-Flash?
Se ofrece al precio de lista oficial de Zhipu: $0.15 por millón de tokens de entrada, $0.03 por millón de lecturas de entrada en caché y $0.50 por millón de tokens de salida, aproximadamente una décima parte del precio oficial de GLM-5.3. Los cargos son el precio de lista por el uso real, detallados por solicitud en la consola, y el precio unitario efectivo depende del grupo de su plan. Los precios por volumen para empresas están disponibles en la página de precios.
¿Admite entrada multimodal y llamadas a herramientas?
Sí. Es el primer miembro nativamente multimodal de la familia GLM-5: acepta texto, imágenes, video y archivos como entrada y devuelve texto. Las llamadas a funciones (tools / tool_calls) están verificadas en nuestra ruta de producción; para streaming, active tool_stream: true, y la traza de razonamiento se devuelve en reasoning_content.
¿GLM-5.3-Flash o GLM-5.3?
Ambos ofrecen una ventana de contexto de 1M. El precio oficial de Flash es aproximadamente una décima parte del de GLM-5.3, así que las cargas de alto volumen (chat cotidiano, bucles de agentes, procesamiento por lotes con contexto largo) deberían empezar con Flash. Las cargas existentes ajustadas para GLM-5.3 pueden seguir en él. Cuando los grupos de su clave incluyen ambos modelos, una sola clave invoca cualquiera de los dos, así que puede integrar ambos y repartir el tráfico según los resultados medidos.
¿Cuál es la longitud máxima de salida?
Hasta 128K tokens de salida por respuesta, dentro de una ventana de contexto de 1M. Use streaming para salidas largas, de modo que los tiempos de espera en el borde no corten la conexión, y añada stream_options: {"include_usage": true} si necesita estadísticas de uso en el flujo.