 HopBase
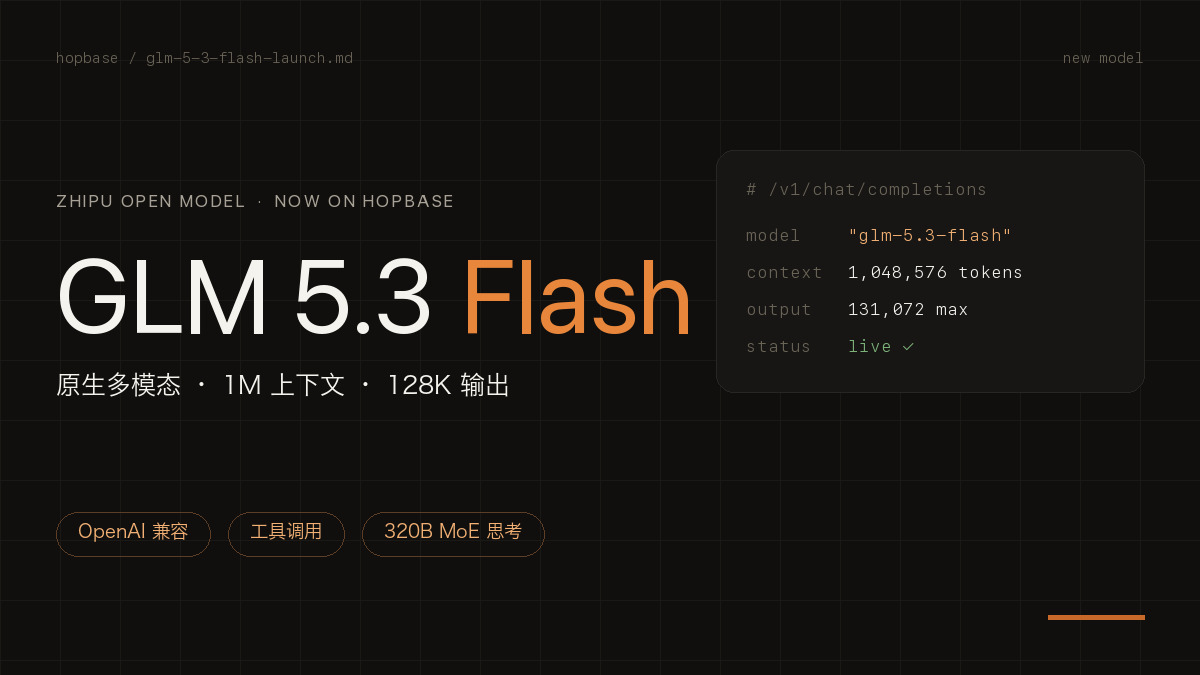
智譜 GLM-5.3-Flash(模型 ID glm-5.3-flash)已經上線 HopBase,走 OpenAI 相容的 POST /v1/chat/completions,任何 OpenAI SDK 換個模型名就能調。它是 320B 總參、每 token 啟用 18B 的 MoE 模型,也是 GLM-5 系列首個原生多模態成員:輸入支援文字、圖像、影片與檔案,輸出文字;上下文 1M,單次最多 128K 輸出,思考過程在 reasoning_content 返回。計費按智譜(Z.ai)國際站官方牌價:每百萬 token 輸入 $0.15、快取命中 $0.03、輸出 $0.50,是 GLM-5.3 官方定價的約十分之一。金鑰所含分組包含 glm-5.3-flash 即可呼叫。
怎麼呼叫
- OpenAI 相容單端點:
POST /v1/chat/completions,Base URL 為https://api.hop-base.com/v1,SDK 只需替換 base URL 與 API Key。 - 模型 ID 寫全:
glm-5.3-flash。裸名或自行縮寫調不通,完整 ID 以GET /v1/models返回為準。 - 確認可用:金鑰所含分組包含
glm-5.3-flash即可呼叫,以GET /v1/models為準;缺的話在控制台給金鑰加上對應分組。 - 思考過程獨立欄位:推理內容走
reasoning_content,正文在content,兩者分開,前端不必自行切分。
價格:按官方牌價接入
| 項目(每百萬 token) | GLM-5.3-Flash |
|---|---|
| 輸入 | $0.15 |
| 快取命中讀取 | $0.03 |
| 輸出 | $0.50 |
這是智譜公布的官方牌價,官方定價口徑為 GLM-5.3 的約十分之一。結算按「牌價 × 實際用量」,控制台按請求給出分項成本,實際單價以你所在分組為準。快取命中讀取不到輸入價的三分之一,反覆讀同一前綴的 Agent 迴圈與長對話省得最多。企業用量請透過價格頁聯絡商務報價。
規格與實測
- 上下文與輸出:1M 上下文,單次最多 128K 輸出 token。
- 原生多模態輸入:文字、圖像、影片、檔案,輸出為文字。
- 架構:混合稀疏與線性注意力。按智譜官方數據,相對 GLM-5.3 注意力計算減少 3.01 倍、KV 快取減少 4.44 倍,這也是它能把價格壓到約十分之一的底氣。
- 我方實測通過:非串流、串流(
stream_options.include_usage能正常拿到 usage)、函式呼叫(tool_calls結構完整)、reasoning_content思考過程,四項都在生產鏈路上跑過。
參數建議
- 官方推薦
temperature: 1、top_p: 0.95、reasoning_effort: "max",不要照搬其它模型的低溫度習慣。 - 思考模式只支援開啟:沒有關閉思考的開關,需要短回覆就用提示詞與
max_tokens控制。 - 串流場景建議同時開
stream: true與tool_stream: true;要在串流裡拿 usage,記得帶stream_options: {"include_usage": true}。
三分鐘接入
curl https://api.hop-base.com/v1/chat/completions \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{"role": "user", "content": "用三句話介紹你自己"}],
    "temperature": 1,
    "top_p": 0.95,
    "stream": true,
    "stream_options": {"include_usage": true}
}'完整接入說明、工具呼叫與多模態範例見GLM-5.3-Flash 接入文件。已有金鑰的使用者先用 GET /v1/models 確認含 glm-5.3-flash,缺的話在控制台給金鑰加上對應分組即可開始用。
常見問題
GLM-5.3-Flash 怎麼呼叫?
走 OpenAI 相容端點 POST https://api.hop-base.com/v1/chat/completions,模型 ID 填 glm-5.3-flash,任何 OpenAI SDK 換個模型名即可,不用改認證方式。前提是金鑰所含分組包含 glm-5.3-flash;完整可用模型清單以 GET /v1/models 返回為準,缺的話在控制台給金鑰加上對應分組。
GLM-5.3-Flash 的價格是多少?
按智譜官方牌價接入:每百萬 token 輸入 $0.15、快取命中讀取 $0.03、輸出 $0.50,官方定價口徑為 GLM-5.3 的約十分之一。結算按牌價乘實際用量,控制台按請求給出分項成本,實際單價以所在分組為準。企業用量可透過價格頁聯絡商務報價。
支援多模態與工具呼叫嗎?
支援。它是 GLM-5 系列首個原生多模態成員,輸入接受文字、圖像、影片與檔案,輸出為文字。函式呼叫(tools / tool_calls)在我方生產鏈路實測通過;串流建議同時開 tool_stream: true,思考過程在 reasoning_content 欄位返回。
和 GLM-5.3 怎麼選?
兩者都是 1M 上下文。Flash 的官方定價是 GLM-5.3 的約十分之一,日常對話、Agent 迴圈、長上下文批次處理這類量大的負載優先用 Flash;需要 GLM-5.3 既有效果基線的存量業務可以繼續用原模型,金鑰的分組同時包含兩個模型時一把 key 都能調,可以並行接入按實際效果切流。
最大能輸出多少 token?
單次最多 128K 輸出 token,上下文視窗 1M。長輸出建議用串流,避免長連線被邊緣逾時切斷;要在串流裡拿到 usage 統計,請求裡帶上 stream_options: {"include_usage": true}。