 HopBase
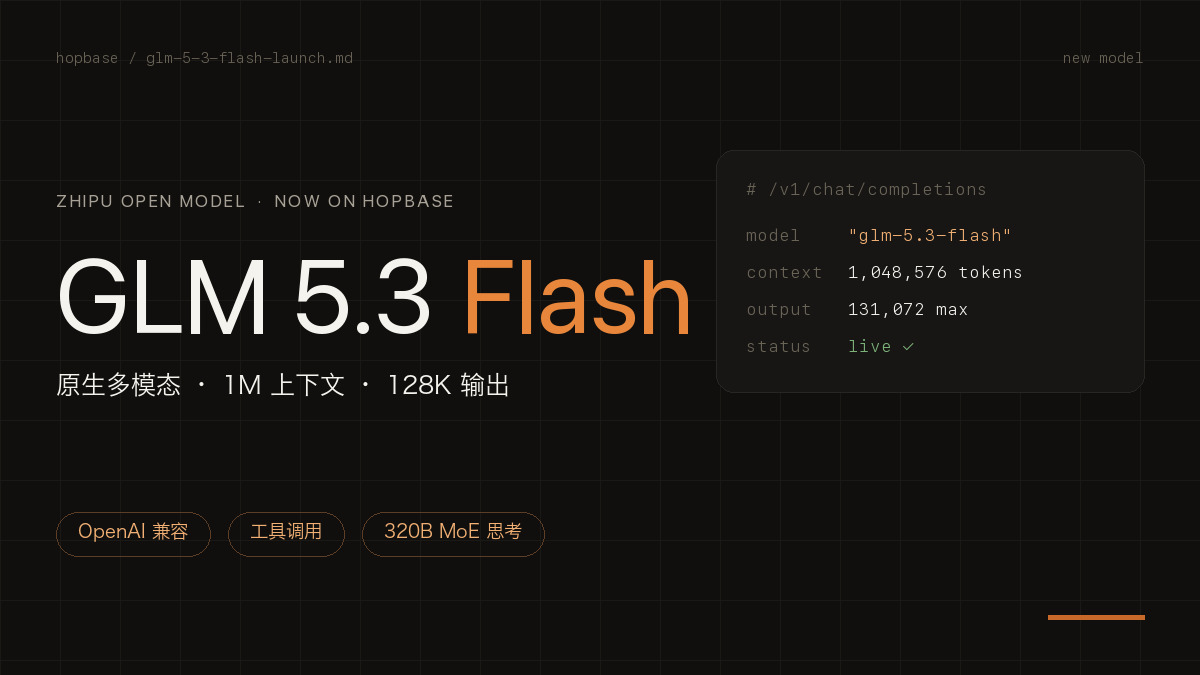
結論から言うと、Zhipu の GLM-5.3-Flash(モデル ID glm-5.3-flash)が HopBase で利用可能になりました。OpenAI 互換の POST /v1/chat/completions エンドポイントで提供しているため、OpenAI SDK ならモデル名を差し替えるだけで使えます。総パラメータ 320B、1 トークンあたり 18B を活性化する Mixture-of-Experts モデルで、GLM-5 ファミリー初のネイティブマルチモーダルモデルです。テキスト、画像、動画、ファイルを入力として受け付け、テキストを返します。コンテキストウィンドウは 1M トークン、1 回の応答で最大 128K トークンを出力でき、推論過程は独立した reasoning_content フィールドで返されます。HopBase ではZhipu(Z.ai)国際版の公式定価で課金します——入力 100 万トークンあたり $0.15、キャッシュ入力 100 万トークンあたり $0.03、出力 100 万トークンあたり $0.50 で、GLM-5.3 の公式価格の約 10 分の 1 です。所属グループにこのモデルが含まれるキーなら今すぐ呼び出せます——キーで利用できるモデルは GET /v1/models で確認できます。
呼び出し方
- OpenAI 互換のエンドポイントひとつ:
POST /v1/chat/completions、ベース URL はhttps://api.hop-base.com/v1。SDK はベース URL と API キーを差し替えるだけです。 - 完全なモデル ID を指定:
glm-5.3-flash。省略した名前では解決されません。正式な一覧はGET /v1/modelsで取得してください。 - 利用権限:
glm-5.3-flashを含むグループがキーに必要です。GET /v1/modelsに表示されない場合は、コンソールでそのグループをキーに追加してください。 - 推論過程は専用フィールド:思考過程は
reasoning_content、回答はcontentで返されるため、クライアント側で切り分ける必要はありません。
料金:公式定価のまま
| 100 万トークンあたり | GLM-5.3-Flash |
|---|---|
| 入力 | $0.15 |
| キャッシュ入力の読み取り | $0.03 |
| 出力 | $0.50 |
これらは Zhipu が公開している定価で、公式価格は GLM-5.3 の約 10 分の 1 です。料金は「定価 × 実際の使用量」で、コンソールにリクエストごとの内訳が表示されます。実際の単価はご利用のプラングループによって決まります。キャッシュ読み取りは入力価格の 3 分の 1 未満なので、同じプレフィックスを繰り返し読むエージェントループや長い会話ほど節約効果が大きくなります。エンタープライズでの大量利用は、料金ページから営業担当にお問い合わせください。
仕様と検証結果
- コンテキストと出力:1M のコンテキストウィンドウ、1 回の応答で最大 128K の出力トークン。
- ネイティブマルチモーダル入力:テキスト、画像、動画、ファイルを入力し、テキストを出力。
- アーキテクチャ:スパースアテンションと線形アテンションのハイブリッド。Zhipu 自身の数値によると、GLM-5.3 と比べてアテンション計算量を 3.01 倍、KV キャッシュを 4.44 倍削減しており、これが約 10 分の 1 の価格を可能にしています。
- 本番経路で検証済み:非ストリーミング、ストリーミング(
stream_options.include_usageで usage を取得)、関数呼び出し(tool_callsが欠けずに返る)、reasoning_contentの思考過程。
パラメータの推奨設定
- Zhipu は
temperature: 1、top_p: 0.95、reasoning_effort: "max"を推奨しています。他のモデルで使っている低温度のデフォルト設定を流用しないでください。 - 思考モードは常にオン:無効化するスイッチはないため、応答の長さはプロンプトと
max_tokensで制御してください。 - ストリーミングでは
stream: trueとtool_stream: trueの両方を有効にします。ストリーム内で usage が必要ならstream_options: {"include_usage": true}を追加してください。
3 分で接続
curl https://api.hop-base.com/v1/chat/completions \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "glm-5.3-flash",
    "messages": [{"role": "user", "content": "Introduce yourself in three sentences"}],
    "temperature": 1,
    "top_p": 0.95,
    "stream": true,
    "stream_options": {"include_usage": true}
  }'
接続の詳細、ツール呼び出し、マルチモーダルの例は GLM-5.3-Flash 接続ガイドをご覧ください。すでにキーをお持ちの場合は GET /v1/models を確認し、glm-5.3-flash がなければ、それを含むグループをコンソールでキーに追加すればすぐに呼び出せます。
よくある質問
GLM-5.3-Flash はどうやって呼び出しますか?
モデル ID glm-5.3-flash を指定して、OpenAI 互換のリクエストを POST https://api.hop-base.com/v1/chat/completions に送信します。OpenAI SDK ならモデル名を差し替えるだけで動作し、認証方法も変わりません。キーにはこのモデルを含むグループが必要で、そのキーで利用できるモデルの正式な一覧は GET /v1/models で確認できます。
GLM-5.3-Flash の料金はいくらですか?
Zhipu の公式定価で提供しています:入力 100 万トークンあたり $0.15、キャッシュ入力の読み取り 100 万トークンあたり $0.03、出力 100 万トークンあたり $0.50 で、GLM-5.3 の公式価格の約 10 分の 1 です。料金は定価 × 実際の使用量で、コンソールにリクエストごとの内訳が表示されます。実際の単価はご利用のプラングループによって決まります。エンタープライズ向けのボリューム価格は料金ページからご相談いただけます。
マルチモーダル入力とツール呼び出しに対応していますか?
はい。GLM-5 ファミリー初のネイティブマルチモーダルモデルで、テキスト、画像、動画、ファイルを入力として受け付け、テキストを返します。関数呼び出し(tools / tool_calls)は本番経路で検証済みです。ストリーミングでは tool_stream: true を有効にしてください。推論過程は reasoning_content で返されます。
GLM-5.3-Flash と GLM-5.3 のどちらを選ぶべきですか?
どちらも 1M のコンテキストウィンドウを備えています。Flash の公式価格は GLM-5.3 の約 10 分の 1 なので、日常的なチャット、エージェントループ、長いコンテキストのバッチ処理といった大量のワークロードは Flash から始めるのがおすすめです。GLM-5.3 に合わせて調整済みの既存ワークロードはそのまま使い続けて構いません。キーのグループに両方のモデルが含まれていれば、1 本のキーでどちらも呼び出せるため、両方を接続して実測結果に応じてトラフィックを移せます。
最大出力長はどれくらいですか?
1M のコンテキストウィンドウの中で、1 回の応答につき最大 128K の出力トークンです。長い出力ではエッジのタイムアウトで接続が切れないようストリーミングを使い、ストリーム内で使用量の統計が必要なら stream_options: {"include_usage": true} を追加してください。