 HopBase
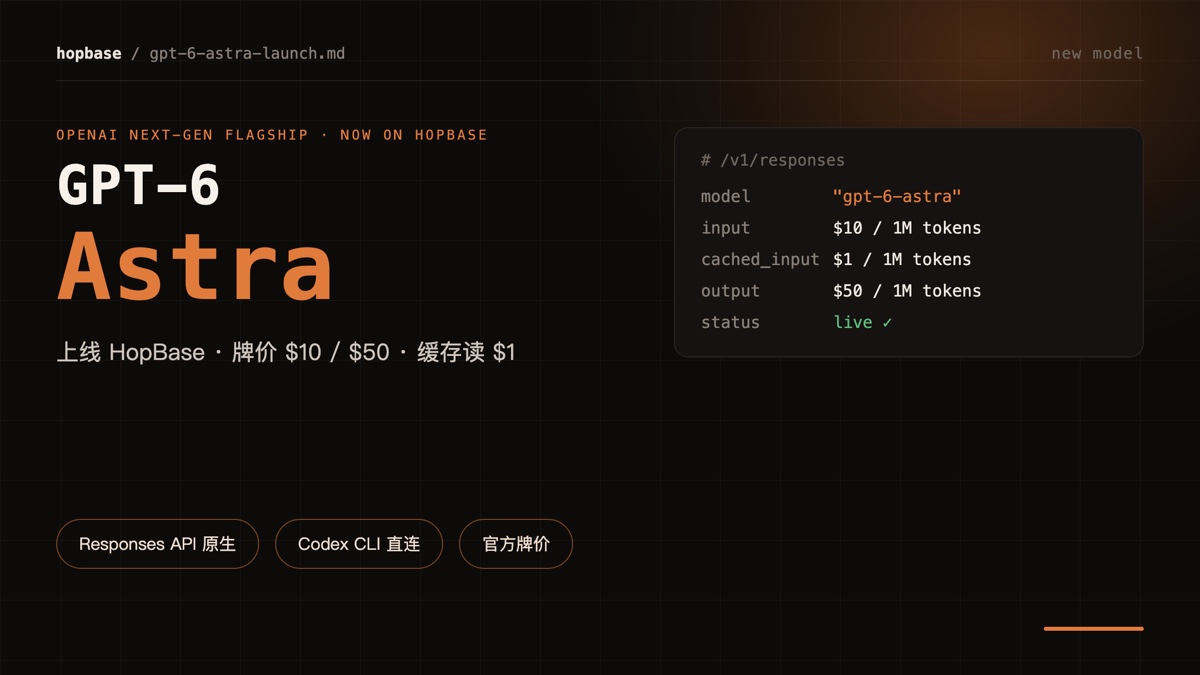
Respuesta corta: GPT-6 Astra (ID de modelo gpt-6-astra) ya está disponible en HopBase; consulte GET /v1/models con su clave, y con las claves existentes basta con cambiar el nombre del modelo. Tanto /v1/responses como /v1/chat/completions funcionan de forma nativa con el SDK de OpenAI, y Codex CLI no requiere cambios de URL base ni de autenticación. Como OpenAI todavía está desplegando GPT-6 por fases, la disponibilidad es la que devuelva GET /v1/models para su clave, así que conviene comprobarlo antes de llamar en lugar de encontrarse con un 404. Se ofrece al precio de lista de OpenAI: $10 de entrada, $1 de entrada en caché y $50 de salida por millón de tokens, frente a los $4 / $0.40 / $20 actuales de GPT-5.6 Sol. Las lecturas en caché cuestan una décima parte del precio de entrada, lo que favorece los bucles de agentes y las conversaciones largas. Se recomienda usar streaming: en nuestras mediciones, stream=true devolvió el primer token de forma estable en 1.5–3.6 segundos con prompts cortos, mientras que las respuestas sin streaming oscilaron entre 2 segundos y 2 minutos, y las solicitudes de cola podían alcanzar los tiempos de espera del borde de la CDN.
El buque insignia de nueva generación de OpenAI, GPT-6 Astra (ID de modelo gpt-6-astra), ya está disponible en HopBase. Consulte GET /v1/models con su clave — si aparece en la lista, solo tiene que cambiar el nombre del modelo.
Cómo llamarlo
- Nativo en Responses y Chat Completions: tanto
/v1/responsescomo/v1/chat/completionsfuncionan directamente, sin cambios en el SDK de OpenAI. - Codex CLI funciona tal cual: indique
gpt-6-astracomo nombre del modelo; no hace falta cambiar la URL base ni la autenticación. - Despliegue por fases: OpenAI todavía está liberando GPT-6 por lotes, así que la disponibilidad real es la que devuelva
GET /v1/modelspara su clave — compruébelo antes de llamar en lugar de encontrarse con un 404.
Precios: al precio de lista de OpenAI
| Por 1M de tokens | GPT-6 Astra | GPT-5.6 Sol (precio actual) |
|---|---|---|
| Entrada | $10 | $4 |
| Entrada en caché | $1 | $0.40 |
| Salida | $50 | $20 |
Las lecturas en caché cuestan una décima parte del precio de entrada, por lo que los bucles de agentes y las conversaciones largas — cargas de trabajo que vuelven a leer el mismo prefijo una y otra vez — son las que más ahorran. La facturación es el precio de lista por el uso real, visible en tiempo real en la consola; para volúmenes empresariales, contacte a través de la página de precios.
Recomendación: prefiera el streaming
En nuestras mediciones, las llamadas con streaming (stream=true) devuelven el primer token de forma estable en 1.5–3.6 segundos (12 muestras con streaming y prompts cortos en la ruta de producción, 2026-09-05). Las solicitudes sin streaming varían mucho actualmente del lado del proveedor (de 2 segundos a 2 minutos en nuestras pruebas), y las solicitudes de cola pueden alcanzar los tiempos de espera del borde de la CDN.
Las cargas de chat, agentes y Codex ya usan streaming, por lo que no se ven afectadas. Si su backend encapsula llamadas sin streaming, se recomienda pasar por ahora a streaming y agregar la respuesta de su lado. Estamos siguiendo el comportamiento del proveedor.
Integración en tres minutos
curl https://api.hop-base.com/v1/responses \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Hello, introduce yourself",
    "stream": true
  }'
Los pasos completos de integración para Chat Completions y Codex CLI están en la documentación de referencia de modelos. Si ya tiene una clave, basta con cambiar el nombre del modelo a gpt-6-astra.
Preguntas frecuentes
¿Se puede llamar a GPT-6 Astra ahora mismo?
Sí. Consulte GET /v1/models con su clave — si aparece en la lista, cambie el nombre del modelo a gpt-6-astra. OpenAI todavía está desplegándolo por fases, así que la disponibilidad es la que devuelva GET /v1/models para su clave; compruébelo antes de llamar.
¿Cuánto cuesta GPT-6 Astra?
Se ofrece al precio de lista de OpenAI: $10 de entrada, $1 de entrada en caché y $50 de salida por millón de tokens. La facturación es el precio de lista por el uso real, con el costo de cada solicitud desglosado en la consola. Para volúmenes empresariales, contacte a través de la página de precios.
¿Qué endpoints y herramientas se admiten?
Tanto Responses (/v1/responses) como Chat Completions (/v1/chat/completions) funcionan de forma nativa, sin cambios en el SDK de OpenAI. En Codex CLI solo hay que cambiar el nombre del modelo — sin cambios de URL base ni de autenticación.
¿Por qué se recomienda el streaming?
Según mediciones con prompts cortos en la ruta de producción del 2026-09-05, la latencia del primer token en streaming se mantuvo estable en 1.5-3.6 segundos, mientras que los tiempos de respuesta sin streaming variaban tanto que las solicitudes de cola pueden alcanzar los tiempos de espera del borde de la CDN. Las cargas de chat, agentes y Codex ya usan streaming y no se ven afectadas; si su backend encapsula llamadas sin streaming, pase por ahora a streaming y agregue la respuesta de su lado.
¿Cómo se compara con GPT-5.6 y Claude Fable 5.1?
Para precio, latencia y un método de selección basado en el costo de un fallo frente a GPT-5.6, consulte GPT-6 Astra vs GPT-5.6. Claude Fable 5.1 tiene el mismo precio de lista y se diferencia en la caché y el protocolo — consulte mismo precio, factura distinta.
Para evaluaciones empresariales y pruebas comparativas de selección de modelos, hable con un asesor; los pasos de integración están en la documentación.