 HopBase
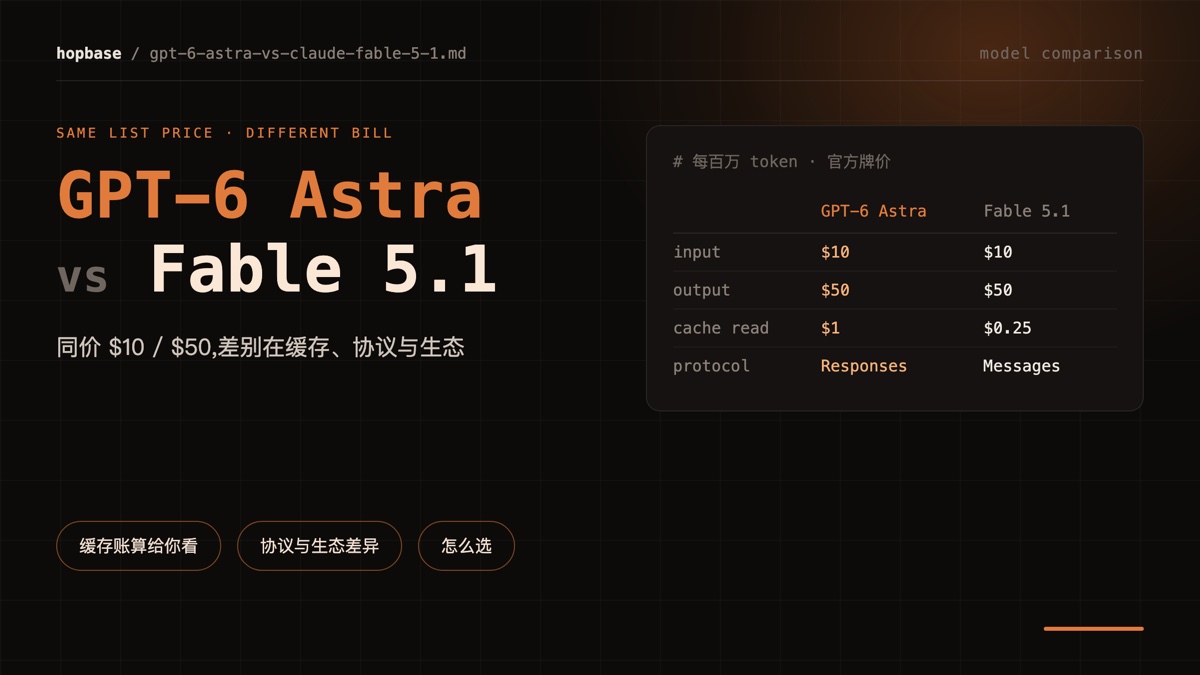
Respuesta corta: GPT-6 Astra y Claude Fable 5.1 tienen exactamente el mismo precio de lista de entrada y de salida: $10 y $50 por millón de tokens. Por eso, "cuál es más caro" es la pregunta equivocada. Hay tres factores que realmente determinan su factura. Primero, el modelo de precios de la caché: Fable 5.1 cobra $0.25 por acierto de caché (2.5% del precio de entrada) frente a $1 (10%) de GPT-6 Astra, pero Anthropic factura aparte la escritura en caché, mientras que OpenAI no ha publicado un precio de escritura en caché para GPT-6; el punto de equilibrio se sitúa en unas diecisiete reutilizaciones del mismo prefijo, y el cálculo aparece más abajo. Segundo, el protocolo y el ecosistema: Fable usa Anthropic Messages y es nativo de Claude Code, GPT-6 usa OpenAI Responses y Chat Completions y es nativo de Codex CLI, y en una base de código existente el costo de migración suele superar la diferencia de capacidad. Tercero, la transparencia de las especificaciones y la disponibilidad: Fable 5.1 tiene publicados una ventana de contexto de 1M y una salida máxima de 128K y está disponible para todos, mientras que OpenAI no ha publicado la ventana de contexto de GPT-6 Astra y lo sigue lanzando por fases.
Precio de lista: la entrada y la salida son idénticas
| Por 1M de tokens | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| Entrada | $10 | $10 |
| Salida | $50 | $50 |
| Lectura de caché | $1 (10% de la entrada) | $0.25 (2.5% de la entrada) |
| Escritura en caché | No publicado | $12.50 (5 min) / $20 (1 hora) |
Ambos se ofrecen al precio de lista del proveedor; los precios completos están en la página de precios. Fíjese en las dos últimas filas: son dos filosofías realmente distintas de facturación de la caché, y son la única fuente de diferencia en su factura.
El cálculo de la caché: un punto de equilibrio que puede calcular usted mismo
El modelo de Anthropic es "escritura cara, lectura muy barata". El de OpenAI es "lectura moderada, precio de escritura no publicado". Comparando solo lo que se ha publicado, sea N el número de veces que se reutiliza el mismo prefijo:
- Fable 5.1 (caché de 5 minutos): una escritura a $12.50/M + N lecturas a $0.25/M
- GPT-6 Astra: N lecturas a $1/M
Al igualarlos se obtiene N = 12.50 ÷ (1.00 − 0.25) ≈ 16.7. Dicho de otro modo:
- Si reutiliza el mismo prefijo más de unas diecisiete veces, la factura de caché de Fable 5.1 es más barata. Con el nivel de caché de una hora ($20/M), el umbral sube a unas veintisiete.
- Por debajo de ese umbral, GPT-6 Astra es más barato: el costo de escritura todavía no se ha amortizado.
Un ejemplo concreto: un prefijo de 15,000 tokens con prompt de sistema más definiciones de herramientas, reutilizado veinte veces en una sesión. Con Fable 5.1 cuesta $0.1875 escribirlo más $0.075 leerlo, es decir, $0.2625. Con GPT-6 Astra cuesta $0.300 en lecturas, y su precio de escritura sigue sin publicarse, por lo que la cifra real podría ser mayor. La diferencia es pequeña, pero la tendencia es clara: cuanto más largo sea el prefijo y más se reutilice, más gana el modelo de caché de Anthropic.
Una advertencia que conviene decir con claridad: esto es aritmética sobre precios publicados, no un sustituto de su propia factura. Las tasas de acierto reales dependen de la estabilidad del prefijo, el TTL y el enrutamiento concurrente, y las estimaciones fallan con frecuencia. Los registros de uso de HopBase desglosan por solicitud el costo de entrada, de aciertos de caché y de salida, así que una semana de tráfico real vale más que cualquier fórmula. Para aumentar la tasa de aciertos desde el principio, consulte la guía de costos de la caché de prompts.
Protocolo y ecosistema: normalmente el costo mayor
| GPT-6 Astra | Claude Fable 5.1 | |
|---|---|---|
| Protocolo | OpenAI Responses / Chat Completions | Anthropic Messages (/v1/messages) |
| CLI nativa | Codex CLI | Claude Code |
| SDK | OpenAI SDK (solo cambian la URL base y la API key) | Anthropic SDK (solo cambian la URL base y la API key) |
Si su servicio ya está construido sobre uno de estos SDK, pasar al otro implica rehacer la construcción de solicitudes, el análisis de eventos de streaming, el formato de llamadas a herramientas y el manejo de errores. Ese trabajo suele pesar más que la diferencia de capacidad entre los dos modelos. Calcule el costo de la migración antes de discutir sobre el modelo.
Fable 5.1 también trae algunos cambios de comportamiento que conviene conocer al migrar desde versiones anteriores de Claude: ya no existen las llamadas forzadas a herramientas (los valores any y tool de tool_choice devuelven 400), los bloques de razonamiento están vinculados al modelo y deben reenviarse sin modificaciones, y no se admite el prellenado de la respuesta del asistente. Los detalles están en el artículo de lanzamiento de Fable 5.1.
Transparencia de especificaciones y disponibilidad
- Claude Fable 5.1: ventana de contexto publicada de 1M y salida máxima de 128K, razonamiento adaptativo siempre activo (profundidad controlada mediante
output_config.effort), disponible para todos; consulteGET /v1/modelscon su clave. - GPT-6 Astra: a la fecha de redacción, OpenAI no ha publicado la ventana de contexto ni la salida máxima, y nosotros no indicamos especificaciones que el proveedor no haya confirmado. Todavía se está lanzando por fases, así que consulte
GET /v1/modelscon su clave para ver si está disponible.
Para cualquier cosa que deba incluirse en una propuesta técnica con un compromiso concreto de capacidad, esa diferencia es real: uno tiene una cifra oficial que puede citarse; el otro, por ahora, solo admite "lo que devuelva la API".
Cómo elegir
- Si ya está dentro de un ecosistema, quédese. El costo de migración suele superar la diferencia de capacidad, salvo que tenga un fallo concreto y reproducible que señalar.
- Para cargas de trabajo de agentes con prefijos largos, inclínese por Fable 5.1. A partir de unas diecisiete reutilizaciones, la factura de caché empieza a ganar con claridad, y estas cargas de trabajo son precisamente las que más dependen de la caché.
- Para una experiencia nativa con Codex CLI, o una cadena de herramientas ya construida sobre el protocolo de OpenAI, elija GPT-6 Astra. Con el mismo precio de lista, las horas de ingeniería que se ahorra son dinero real.
Ambos modelos se ofrecen a precio de lista en HopBase y se pueden llamar con una sola clave, lo que facilita una prueba A/B con tráfico real. El método de división del tráfico es la lista de verificación de tres pasos de nuestra comparativa entre GPT-6 y GPT-5.6.
Preguntas frecuentes
¿Cuál es más caro, GPT-6 Astra o Claude Fable 5.1?
Sus precios de lista de entrada y salida son idénticos: $10 y $50 por millón de tokens. La diferencia está totalmente en la caché: Fable 5.1 cobra $0.25 por acierto de caché y $12.50 (5 min) o $20 (1 hora) por escritura; GPT-6 Astra cobra $1 por acierto y no ha publicado un precio de escritura. Cuál resulta más barato en total depende de la frecuencia con que reutilice un prefijo.
¿Cómo calculo el punto de equilibrio de la caché?
Con N reutilizaciones de un prefijo, Fable 5.1 cuesta 12.50 + 0.25N por millón de tokens en el nivel de cinco minutos, y GPT-6 Astra cuesta 1.00N. Se igualan en N ≈ 16.7, así que a partir de unas diecisiete reutilizaciones Fable es más barato. En el nivel de caché de una hora, el umbral es de unas veintisiete.
¿Puedo llamar a ambos modelos con la misma clave?
Sí. Ambos se ofrecen a precio de lista en HopBase y se pueden llamar con una sola clave empresarial, sujeta a los permisos de grupo, lo que facilita dividir el tráfico real para una prueba A/B. Tenga en cuenta que los protocolos difieren: Fable usa /v1/messages y GPT-6 usa /v1/responses o /v1/chat/completions.
¿Cuál es la ventana de contexto de GPT-6 Astra?
A la fecha de redacción, OpenAI no ha publicado una cifra oficial, y nosotros no indicamos especificaciones que un proveedor no haya confirmado. Tome como referencia los metadatos de GET /v1/models y sus resultados reales. Claude Fable 5.1 sí tiene publicados una ventana de contexto de 1M y una salida máxima de 128K.
¿Cómo confirmo que estoy llegando a estos modelos y no a un sustituto?
Revise el campo model devuelto en el cuerpo de la respuesta y ejecute un conjunto fijo de pruebas como comparación lado a lado. El método completo está en la autoprueba de fidelidad de la API.
Para evaluaciones empresariales y pruebas de selección entre proveedores, hable con un asesor; los pasos de integración están en la documentación.