 HopBase
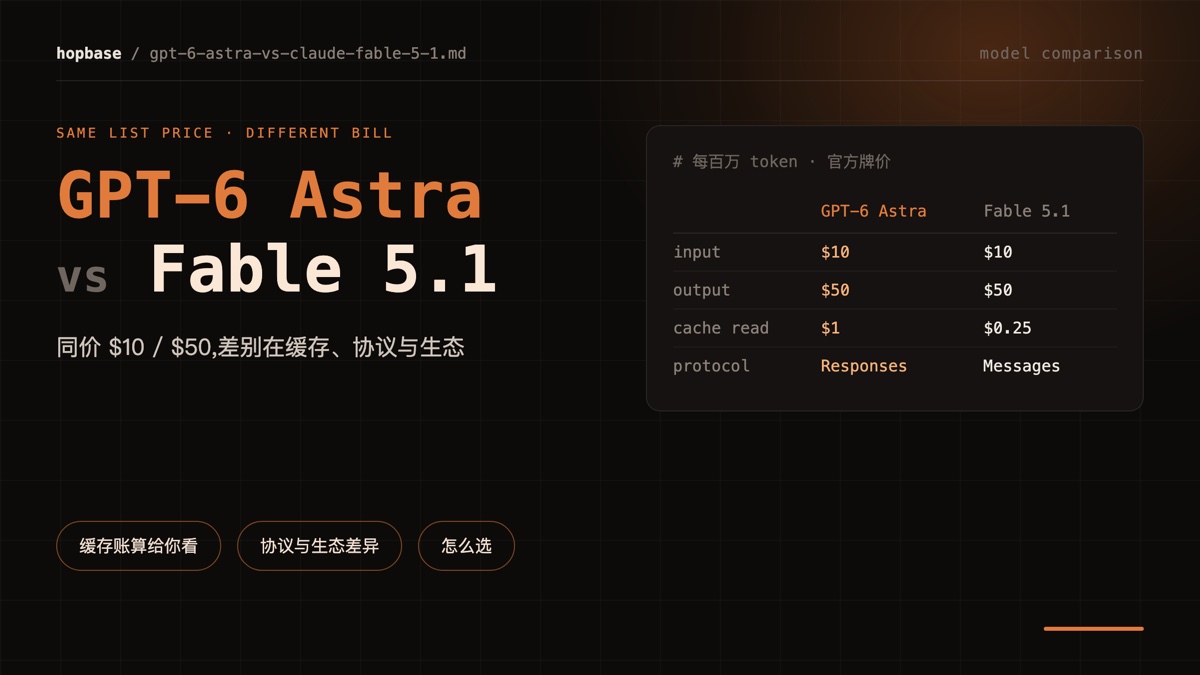
結論から言うと、GPT-6 Astra と Claude Fable 5.1 の入力・出力の定価はまったく同じで、100 万トークンあたり $10 と $50 です。したがって「どちらが高いか」は問いの立て方として適切ではありません。実際に請求額を左右するのは 3 点です。1 つ目はキャッシュの料金モデルです。Fable 5.1 はキャッシュヒットが $0.25(入力価格の 2.5%)で、GPT-6 Astra の $1(10%)より安い一方、Anthropic はキャッシュ書き込みを別途課金し、OpenAI は GPT-6 のキャッシュ書き込み価格を公表していません。損益分岐点は同じプレフィックスを約 17 回再利用したあたりで、計算は本文で示します。2 つ目はプロトコルとエコシステムです。Fable は Anthropic Messages を話し Claude Code にネイティブ対応、GPT-6 は OpenAI Responses と Chat Completions を話し Codex CLI にネイティブ対応しています。既存のコードベースでは、移行コストのほうが能力差より大きくなるのが普通です。3 つ目は仕様の透明性と提供状況です。Fable 5.1 は 1M のコンテキストウィンドウと 128K の最大出力が公表され、全面提供済みです。一方 OpenAI は GPT-6 Astra のコンテキストウィンドウを公表しておらず、段階的なリリースが続いています。
定価:入力と出力は同一
| 100 万トークンあたり | GPT-6 Astra | Claude Fable 5.1 |
|---|---|---|
| 入力 | $10 | $10 |
| 出力 | $50 | $50 |
| キャッシュ読み取り | $1(入力の 10%) | $0.25(入力の 2.5%) |
| キャッシュ書き込み | 非公表 | $12.50(5 分)/ $20(1 時間) |
どちらもベンダー定価で提供しており、全料金は料金ページに掲載しています。注目すべきは最後の 2 行です。ここにキャッシュ課金についての本質的に異なる 2 つの考え方が表れており、請求額の差が生まれるのはこの部分だけです。
キャッシュの計算:自分で求められる損益分岐点
Anthropic のモデルは「書き込みは高く、読み取りは非常に安い」。OpenAI のモデルは「読み取りは中程度、書き込み価格は非公表」です。公表済みの数字だけで比較し、同じプレフィックスの再利用回数を N とします。
- Fable 5.1(5 分キャッシュ):書き込み 1 回 $12.50/M + 読み取り N 回 $0.25/M
- GPT-6 Astra:読み取り N 回 $1/M
両者を等しいとおくと N = 12.50 ÷ (1.00 − 0.25) ≈ 16.7 になります。つまり、
- 同じプレフィックスを約 17 回より多く再利用するなら、Fable 5.1 のキャッシュ料金のほうが安くなります。1 時間キャッシュ($20/M)の場合、しきい値は約 27 回に上がります。
- しきい値未満なら GPT-6 Astra のほうが安くなります。書き込み料金をまだ償却しきれていないためです。
具体例で見てみましょう。システムプロンプトとツール定義を合わせた 15,000 トークンのプレフィックスを、1 セッション内で 20 回再利用するとします。Fable 5.1 は書き込み $0.1875 と読み取り $0.075 で、合計 $0.2625 です。GPT-6 Astra は読み取りで $0.300 かかり、書き込み価格はまだ非公表なので、実際の金額はさらに高くなる可能性があります。差は小さいものの、方向ははっきりしています。プレフィックスが長く、再利用回数が多いほど、Anthropic のキャッシュモデルが有利になります。
はっきり申し上げておくべき注意点が 1 つあります。これは公表価格に基づく計算であり、実際の請求額の代わりにはなりません。実際のヒット率はプレフィックスの安定性、TTL、並行ルーティングに左右され、見積もりはしばしば外れます。HopBase の使用記録ではリクエストごとに入力・キャッシュヒット・出力のコストを分けて表示するので、実トラフィックを 1 週間流してみるほうがどんな計算式よりも確実です。そもそもヒット率を上げる方法については、プロンプトキャッシュのコストガイドをご覧ください。
プロトコルとエコシステム:たいていこちらのコストが大きい
| GPT-6 Astra | Claude Fable 5.1 | |
|---|---|---|
| プロトコル | OpenAI Responses / Chat Completions | Anthropic Messages(/v1/messages) |
| ネイティブ CLI | Codex CLI | Claude Code |
| SDK | OpenAI SDK(ベース URL と API キーの差し替えのみ) | Anthropic SDK(ベース URL と API キーの差し替えのみ) |
サービスがすでにどちらかの SDK で構築されている場合、もう一方へ移るには、リクエストの組み立て、ストリーミングイベントの解析、ツール呼び出しの形式、エラー処理を作り直す必要があります。その作業量は、たいてい 2 つのモデルの能力差よりも大きな価値を持ちます。モデルについて議論する前に、移行コストを見積もりましょう。
また Fable 5.1 には、古い Claude バージョンから移行する際に知っておくべき挙動の変更がいくつかあります。強制ツール呼び出しは廃止され(tool_choice の any と tool は 400 を返します)、thinking ブロックはモデルに紐づくため一字一句そのまま再送する必要があり、アシスタントのプレフィルには対応していません。詳しくは Fable 5.1 リリース記事をご覧ください。
仕様の透明性と提供状況
- Claude Fable 5.1:1M のコンテキストウィンドウと 128K の最大出力が公表されており、適応型 thinking は常時オン(深さは
output_config.effortで制御)、一般提供済みです。お使いのキーでGET /v1/modelsを確認してください。 - GPT-6 Astra:本稿執筆時点で OpenAI はコンテキストウィンドウも最大出力も公表しておらず、当社もベンダーが確認していない仕様は記載しません。段階的な展開が続いているため、利用可能かどうかはお使いのキーで
GET /v1/modelsを確認してください。
具体的な容量のコミットメントを技術提案書に書く必要がある場合、この違いは無視できません。一方には引用できる公式の数字があり、もう一方は現時点では「API が返す値に従う」としか言えないからです。
選び方
- すでにどちらかのエコシステムにいるなら、そのままにしましょう。具体的で再現可能な不具合を指摘できるのでない限り、移行コストはたいてい能力差を上回ります。
- プレフィックスを多用するエージェント用途なら、Fable 5.1 寄りで。再利用が約 17 回を超えるとキャッシュ料金がはっきり有利になり始めますし、そもそもこうした用途はキャッシュに大きく依存します。
- Codex CLI のネイティブな体験が欲しい、あるいはツールチェーンがすでに OpenAI プロトコルで構築されているなら、GPT-6 Astra を選びましょう。定価が同じなら、節約できるエンジニアリング工数はそのまま実際のお金です。
どちらのモデルも HopBase で定価提供しており、キー 1 本で呼び出せるため、実トラフィックでの A/B テストも簡単です。分割テストの方法は、GPT-6 と GPT-5.6 の比較記事にある 3 ステップのチェックリストをご参照ください。
よくある質問
GPT-6 Astra と Claude Fable 5.1 はどちらが高いですか?
入力・出力の定価は同一で、100 万トークンあたり $10 と $50 です。差はすべてキャッシュにあります。Fable 5.1 はキャッシュヒットが $0.25、書き込みが $12.50(5 分)または $20(1 時間)です。GPT-6 Astra はヒットが $1 で、書き込み価格は公表されていません。どちらの総額が低くなるかは、プレフィックスをどれだけ再利用するかで決まります。
キャッシュの損益分岐点はどう計算しますか?
プレフィックスを N 回再利用する場合、5 分ティアの Fable 5.1 は 100 万トークンあたり 12.50 + 0.25N、GPT-6 Astra は 1.00N です。N ≈ 16.7 で等しくなるので、約 17 回を超えると Fable のほうが安くなります。1 時間キャッシュティアではしきい値は約 27 回です。
同じキーで両方のモデルを呼び出せますか?
はい。どちらも HopBase で定価提供しており、グループの権限に応じて 1 本のエンタープライズキーで呼び出せるため、実トラフィックを分けて A/B テストするのも簡単です。ただしプロトコルが異なる点に注意してください。Fable は /v1/messages、GPT-6 は /v1/responses または /v1/chat/completions を使います。
GPT-6 Astra のコンテキストウィンドウはどれくらいですか?
本稿執筆時点で OpenAI は公式の数字を公表しておらず、当社もベンダーが確認していない仕様は記載しません。GET /v1/models のメタデータと実際の結果を正としてください。なお Claude Fable 5.1 は 1M のコンテキストウィンドウと 128K の最大出力が公表されています。
代替モデルではなく本当にこれらのモデルに届いていることはどう確認しますか?
レスポンスボディに返される model フィールドを確認し、固定のプローブセットを並べて比較してください。詳しい方法は API の真正性セルフテストにまとめています。
エンタープライズでの評価やベンダー横断の選定テストについてはアドバイザーにご相談ください。接続手順はドキュメントにあります。