 HopBase
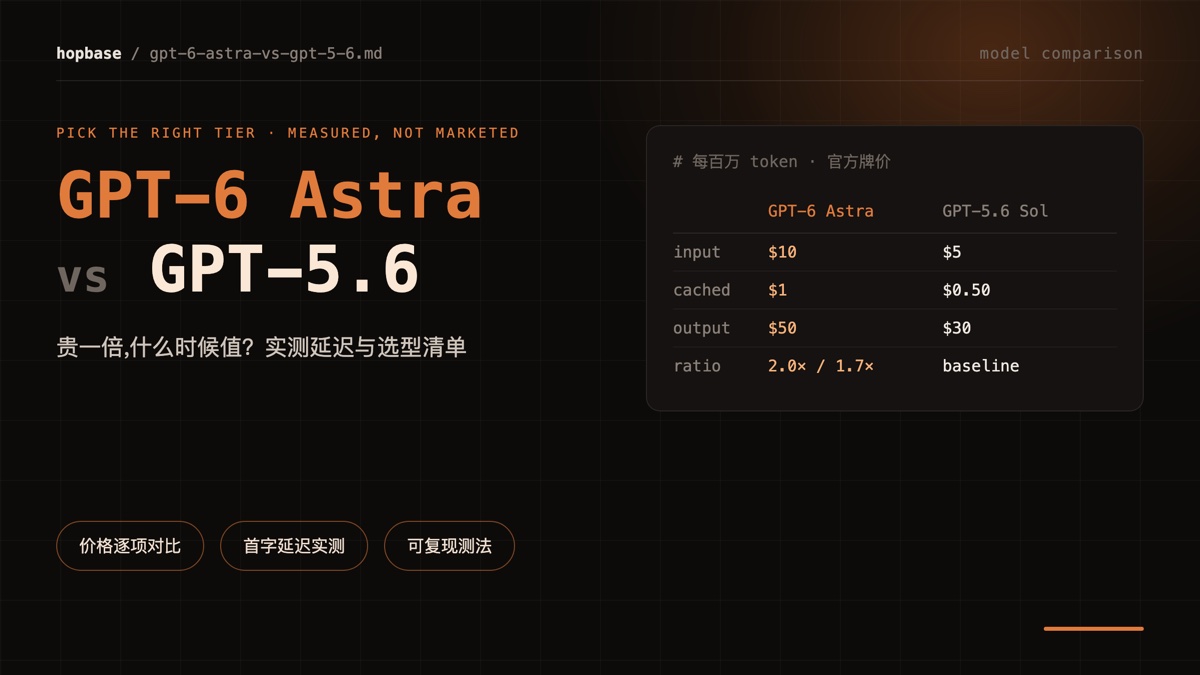
結論から言うと、現在の価格では、GPT-6 Astra の料金は GPT-5.6 Sol に比べて入力・キャッシュ入力・出力のいずれも 2.50 倍です(100 万トークンあたり $10 / $1 / $50 対 $4 / $0.40 / $20)。しかし 2026-09-05 に本番経路で私たち自身が計測したところ、ストリーミングの初回トークンレイテンシは両者とも同じ範囲に収まり、GPT-6 Astra の短いプロンプトでの 12 サンプルは 1.5〜3.6 秒の間でした。つまり、判断の基準はどちらのバージョン番号が大きいかではありません。タスクが 1 回失敗したときのコストで決めるべきです。長時間動くエージェント、複数ファイルにまたがるリファクタリング、多段階の推論や計画など、一度で正解を出す必要がある作業なら、手戻りを 1 回減らした時点で価格差を回収できます。高頻度の短い回答、分類、抽出、大量のリライトなど、リトライが安く済む作業は、引き続き 5.6 系のほうが適しています。以下では、項目ごとの料金、2 つの実ワークロードでの 1 回あたりコスト試算、ご自身で再現できるレイテンシテスト、そして 3 ステップのチェックリストを紹介します。
料金を項目ごとに比較
| 100 万トークンあたり | GPT-6 Astra | GPT-5.6 Sol(現在の価格) | 倍率 |
|---|---|---|---|
| 入力 | $10 | $4 | 2.50× |
| キャッシュ入力 | $1 | $0.40 | 2.50× |
| 出力 | $50 | $20 | 2.50× |
どちらも OpenAI の定価どおりで提供しており、GPT-5.6 Sol は現在の価格で示しています。この価格では入力・キャッシュ入力・出力の倍率がいずれも 2.50 倍なので、入力と出力の比率にかかわらず、合算の倍率はおよそ 2.5 倍です。料金の全体は料金ページをご覧ください。
1 回の呼び出しで実際にかかるコスト
倍率だけではイメージしにくいので、2 つの実際のワークロードで試算します。
ワークロード A:長文ドキュメントの一発処理(入力 20K トークン、出力 2K トークン、キャッシュなし)
- GPT-5.6 Sol:20000 × $4/1M + 2000 × $20/1M = $0.120
- GPT-6 Astra:20000 × $10/1M + 2000 × $50/1M = $0.300
- 差額:1 回あたり $0.18、2.50×
ワークロード B:エージェントループ(同じく入力 20K、ただし 80% がプロンプトキャッシュにヒット、出力 2K)
- GPT-5.6 Sol:4000 × $4/1M + 16000 × $0.4/1M + 2000 × $20/1M = $0.0624
- GPT-6 Astra:4000 × $10/1M + 16000 × $1/1M + 2000 × $50/1M = $0.156
- 差額:1 回あたり $0.0936、2.50×
キャッシュによって絶対額の差はほぼ半分に縮まります。だからこそ高頻度のエージェントワークロードでは、モデルの乗り換えを議論する前にキャッシュヒット率を上げるべきなのです。その方法はプロンプトキャッシュのコストガイドをご覧ください。
レイテンシ:計測方法と再現方法
まず、はっきりさせておきたい落とし穴があります。「レスポンスヘッダーが届いた」と「最初のコンテンツトークンが届いた」は別物です。多くのテストスクリプトは、ストリーム全体を 1 回のブロッキング読み取りで受け取ってから経過時間を計算しています。読み取りバッファを大きく取りすぎると、サーバーが接続を閉じるまで読み取りがブロックされ、1.5 秒の初回トークンが 58 秒という計測結果になってしまいます。実は私たち自身のプローブもまさにこの罠にはまりました。TTFT を測るには、コンテンツを含む最初の SSE イベントの時点で止める必要があります。
最もシンプルに再現できるテストは、curl の time_starttransfer(ヘッダー + 最初のバイト)を使う方法です。
curl -s -N -o /dev/null \
  -w "ttfb=%{time_starttransfer}s total=%{time_total}s\n" \
  https://api.hop-base.com/v1/responses \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Explain vector databases in one sentence",
    "stream": true
  }'
model を gpt-5.6-sol に替えてもう一度実行してください。同じ時間帯、同じプロンプトで、それぞれ N は 20 以上。比べるのは分布であって、単発の呼び出しではありません。2026-09-05 に本番経路で短いプロンプトにより取った 12 件のストリーミングサンプルでは、GPT-6 Astra の初回トークンは 1.5〜3.6 秒の間に収まり、5.6 系も同じ範囲でした。結論:ストリーミングのワークロードでは、レイテンシはどちらかを選ぶ理由になりません。決め手はコストとタスクの成功率です。P95/P99、ストリームの中断率、キャッシュが TTFT に与える影響など、より詳しい方法は LLM API のパフォーマンスをベンチマークする方法をご覧ください。
現時点での実務的な注意点を 1 つ。ストリーミング(stream=true)を優先してください。非ストリーミングの応答時間は現在プロバイダー側でのばらつきが大きく、テール側のリクエストが CDN エッジのタイムアウトに達することがあります。チャット、エージェント、Codex のワークロードはもともとストリーミングなので影響はありません。
3 ステップのチェックリスト
- トークンではなく失敗に値段を付ける。本番コードの変更、顧客向けの文章、データベースに入る構造化抽出など、失敗すると人手で後始末が必要になる作業では、より高いモデルでも手戻り率を 20% から 10% に下げた時点で元が取れます。失敗してもやり直せば済む作業なら、ほぼ確実に安いティアが有利です。
- キャッシュが効くかを確認する。長いシステムプロンプト、大きなツール定義、マルチターンで共有されるプレフィックスがあれば、キャッシュヒットで差はほぼ半分に縮まります。単発の短いリクエストはキャッシュの恩恵がないため、差額をそのまま払うことになります。
- そのうえで実際に比較テストを回す。本番の実トラフィックの一定割合を各モデルに 1 週間振り分け、コンソールの使用記録でモデルごとの実コストと手戻り率を比べてください。他人のベンチマークに判断を委ねないこと。この記事も含めてです。
利用開始と利用可否の確認
GPT-6 Astra が使えるかどうかは、お使いのキーで GET /v1/models を確認してください。Responses と Chat Completions の両エンドポイントがネイティブに動作し、Codex CLI はモデル名を gpt-6-astra に変えるだけで、ベース URL や認証の変更は不要です。
OpenAI は GPT-6 をまだ段階的に展開している最中のため、利用可否はキーに対して GET /v1/models が返す内容で決まります。呼び出す前に確認してください。
curl https://api.hop-base.com/v1/models \
  -H "Authorization: Bearer sk-your-key" | grep gpt-6
リリースの詳細は GPT-6 Astra のリリース記事に、モデルの全一覧はモデルリファレンスのドキュメントにあります。
よくある質問
GPT-6 Astra は GPT-5.6 よりどれくらい高いですか?
GPT-5.6 Sol の現在の価格で比べると、入力で 2.50 倍($10 対 $4)、キャッシュ入力で 2.50 倍($1 対 $0.40)、出力で 2.50 倍($50 対 $20)で、いずれも OpenAI の 100 万トークンあたりの定価です。3 項目の倍率が同じなので、一般的な呼び出しも入出力の比率にかかわらずおよそ 2.5 倍です。キャッシュが変えるのは倍率ではなく絶対額の差です。
初回トークンレイテンシはどれくらい違いますか?
2026-09-05 に本番経路で短いプロンプトにより取ったストリーミングサンプルでは、GPT-6 Astra の初回トークンは 1.5〜3.6 秒の間に収まり、5.6 系と同じ範囲でした。レイテンシはどちらかを選ぶ理由になりません。ご自身のリージョンと時間帯で上記の curl を実行し直してください。単発の呼び出しよりも分布のほうが重要です。
GPT-6 Astra に切り替える価値があるのはどんなときですか?
1 回の失敗が高くつき、一度で正解を出す必要があるタスクです。長時間動くエージェント、複数ファイルにまたがるリファクタリング、複雑な推論や計画などが該当します。逆に、高頻度の短い回答、分類、抽出、大量のリライトなど、リトライのコストがほぼかからない作業は、引き続き 5.6 系のほうがコストパフォーマンスに優れます。
コンテキストウィンドウはどれくらいですか?
本記事の執筆時点で、OpenAI は GPT-6 Astra の公式なコンテキストウィンドウや最大出力を公表しておらず、ベンダーが確認していない数値を私たちが表記することはありません。GET /v1/models が返すメタデータと実際の結果を正としてください。
差し替えられた別のモデルではなく、本当に GPT-6 に届いていることをどう確認できますか?
レスポンスボディで返される model フィールドを確認し、固定のプローブセットを使って並べて比較してください。判別力のある質問の作り方を含む詳しい方法は、API の忠実度セルフテストにまとめています。
法人での評価やモデル選定の比較テストについてはアドバイザーにご相談ください。組み込み手順はドキュメントにあります。