 HopBase
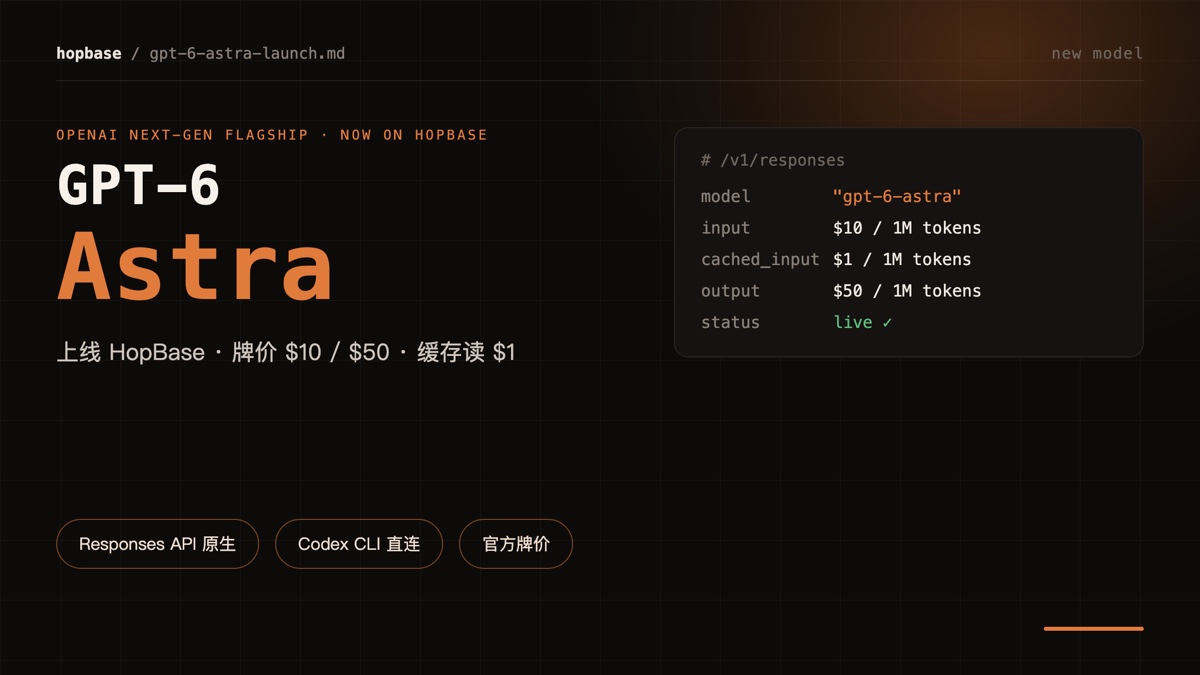
結論から言うと、GPT-6 Astra(モデル ID gpt-6-astra)は HopBase で提供を開始しました。お使いのキーで GET /v1/models を確認してください。既存のキーならモデル名を変えるだけで使えます。/v1/responses と /v1/chat/completions の両方が OpenAI SDK でネイティブに動作し、Codex CLI もベース URL や認証の変更は不要です。OpenAI は GPT-6 を段階的に展開している最中のため、実際に使えるかどうかはキーに対して GET /v1/models が返す内容がすべてです。404 で気づくのではなく、呼び出す前に確認してください。料金は OpenAI の定価どおりで、100 万トークンあたり入力 $10、キャッシュ入力 $1、出力 $50 です(GPT-5.6 Sol は現在の価格で $4 / $0.40 / $20)。キャッシュ読み取りは入力価格の 10 分の 1 なので、エージェントループや長い会話に有利です。ストリーミングの利用をおすすめします。私たちの計測では stream=true の短いプロンプトでの初回トークンは 1.5〜3.6 秒で安定していた一方、非ストリーミングの応答は 2 秒から 2 分までばらつき、テール側のリクエストは CDN エッジのタイムアウトに達することがありました。
OpenAI の次世代フラッグシップモデル GPT-6 Astra(モデル ID gpt-6-astra)が HopBase で利用可能になりました。お使いのキーで GET /v1/models を確認し、一覧に載っていればモデル名を切り替えるだけです。
呼び出し方
- Responses と Chat Completions の両方にネイティブ対応:
/v1/responsesと/v1/chat/completionsのどちらもそのまま動作し、OpenAI SDK はベース URL と API キーを差し替えるだけで使えます。 - Codex CLI もそのまま動作:モデル名を
gpt-6-astraに向けるだけで、ベース URL や認証の変更は不要です。 - 段階的な展開:OpenAI は GPT-6 をまだ順次リリースしている段階のため、実際の利用可否はキーに対して
GET /v1/modelsが返す内容で決まります。404 で気づくのではなく、呼び出す前に確認してください。
料金:OpenAI の定価どおり
| 100 万トークンあたり | GPT-6 Astra | GPT-5.6 Sol(現在の価格) |
|---|---|---|
| 入力 | $10 | $4 |
| キャッシュ入力 | $1 | $0.40 |
| 出力 | $50 | $20 |
キャッシュ読み取りは入力価格の 10 分の 1 なので、同じプレフィックスを何度も読み直すエージェントループや長い会話ほど節約効果が大きくなります。課金は定価 × 実際の使用量で、コンソールでリアルタイムに確認できます。法人での大口利用については、料金ページからお問い合わせください。
おすすめ:ストリーミングを優先
私たちの計測では、ストリーミング呼び出し(stream=true)の初回トークンは 1.5〜3.6 秒で安定して返ってきます(2026-09-05、本番経路で短いプロンプトによるストリーミング 12 回の計測)。非ストリーミングのリクエストは現在プロバイダー側でのばらつきが大きく(テストでは 2 秒〜2 分)、テール側のリクエストは CDN エッジのタイムアウトに達することがあります。
チャット、エージェント、Codex のワークロードはもともとストリーミングなので影響はありません。バックエンドで非ストリーミング呼び出しをラップしている場合は、当面ストリーミングに切り替えて自社側で集約することをおすすめします。プロバイダー側の挙動は引き続き追跡しています。
3 分でできる組み込み
curl https://api.hop-base.com/v1/responses \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Hello, introduce yourself",
    "stream": true
  }'
Chat Completions と Codex CLI の詳しい組み込み手順はモデルリファレンスのドキュメントにあります。すでにキーをお持ちなら、モデル名を gpt-6-astra に切り替えるだけです。
よくある質問
GPT-6 Astra は今すぐ呼び出せますか?
はい。お使いのキーで GET /v1/models を確認し、一覧に載っていればモデル名を gpt-6-astra に切り替えてください。OpenAI はまだ段階的に展開中のため、利用可否はキーに対して GET /v1/models が返す内容で決まります。呼び出す前に確認してください。
GPT-6 Astra の料金はいくらですか?
OpenAI の定価どおりで、100 万トークンあたり入力 $10、キャッシュ入力 $1、出力 $50 です。課金は定価 × 実際の使用量で、リクエストごとのコスト内訳はコンソールで確認できます。法人での大口利用については、料金ページからお問い合わせください。
どのエンドポイントとツールに対応していますか?
Responses(/v1/responses)と Chat Completions(/v1/chat/completions)の両方にネイティブ対応しており、OpenAI SDK はベース URL と API キーを差し替えるだけで使えます。Codex CLI はモデル名を変えるだけで、ベース URL や認証の変更は必要ありません。
なぜストリーミングをすすめるのですか?
2026-09-05 に本番経路で短いプロンプトを使って計測したところ、ストリーミングの初回トークンレイテンシは 1.5-3.6 秒で安定していた一方、非ストリーミングの応答時間はばらつきが大きく、テール側のリクエストが CDN エッジのタイムアウトに達することがありました。チャット、エージェント、Codex のワークロードはもともとストリーミングなので影響はありません。バックエンドで非ストリーミング呼び出しをラップしている場合は、当面ストリーミングに切り替えて自社側で集約してください。
GPT-5.6 や Claude Fable 5.1 と比べてどうですか?
GPT-5.6 との料金・レイテンシの比較と、失敗コストに基づくモデル選定の考え方は GPT-6 Astra vs GPT-5.6 をご覧ください。Claude Fable 5.1 は定価が同じで、キャッシュとプロトコルの面で違いがあります。詳しくは同じ価格、違う請求額をご覧ください。
法人での評価やモデル選定の比較テストについてはアドバイザーにご相談ください。組み込み手順はドキュメントにあります。