 HopBase
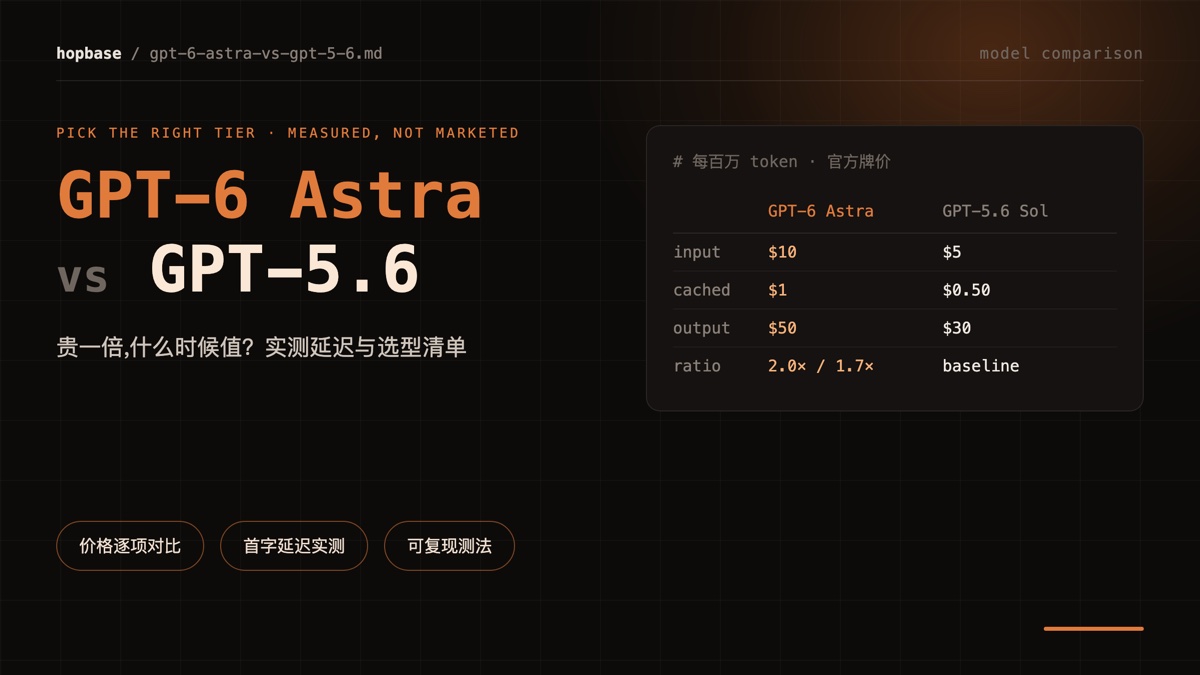
Respuesta corta: con los precios actuales, GPT-6 Astra cuesta 2.50x lo que GPT-5.6 Sol en entrada, entrada en caché y salida: $10 / $1 / $50 frente a $4 / $0.40 / $20 por millón de tokens. Pero en nuestras propias mediciones sobre la ruta de producción del 2026-09-05, la latencia del primer token en streaming de ambos modelos se sitúa en el mismo rango, con las doce muestras de GPT-6 Astra con prompts cortos entre 1.5 y 3.6 segundos. Por eso, la decisión no debería depender de qué número de versión es mayor, sino del costo de una sola tarea fallida. El trabajo que debe salir bien a la primera (agentes de larga duración, refactorizaciones entre varios archivos, razonamiento y planificación de varios pasos) recupera la diferencia de precio en cuanto ahorra una ronda de retrabajo. El trabajo en el que reintentar es barato (respuestas cortas de alta frecuencia, clasificación, extracción, reescritura masiva) sigue siendo mejor atendido por el nivel 5.6. A continuación: los precios partida por partida, el cálculo del costo por llamada para dos cargas de trabajo reales, una prueba de latencia reproducible que puede ejecutar usted mismo y una lista de verificación de tres pasos.
Precios, partida por partida
| Por 1M de tokens | GPT-6 Astra | GPT-5.6 Sol (precio actual) | Relación |
|---|---|---|---|
| Entrada | $10 | $4 | 2.50× |
| Entrada en caché | $1 | $0.40 | 2.50× |
| Salida | $50 | $20 | 2.50× |
Ambos se ofrecen al precio de lista de OpenAI; GPT-5.6 Sol figura con su precio actual. Con estos precios la relación es de 2.50x en entrada, entrada en caché y salida, así que la relación combinada se mantiene en torno a 2.5x sea cual sea su proporción entre entrada y salida. Los precios completos están en la página de precios.
Cuánto cuesta realmente una llamada
Las relaciones son difíciles de interpretar, así que veamos dos cargas de trabajo reales.
Carga A: documento largo en una sola llamada (20K tokens de entrada, 2K tokens de salida, sin caché)
- GPT-5.6 Sol: 20000 × $4/1M + 2000 × $20/1M = $0.120
- GPT-6 Astra: 20000 × $10/1M + 2000 × $50/1M = $0.300
- Diferencia: $0.18 por llamada, 2.50×
Carga B: bucle de agente (la misma entrada de 20K, pero el 80% acierta en la caché de prompts, 2K de salida)
- GPT-5.6 Sol: 4000 × $4/1M + 16000 × $0.4/1M + 2000 × $20/1M = $0.0624
- GPT-6 Astra: 4000 × $10/1M + 16000 × $1/1M + 2000 × $50/1M = $0.156
- Diferencia: $0.0936 por llamada, 2.50×
La caché reduce la diferencia absoluta casi a la mitad. Por eso, en una carga de agentes de alta frecuencia conviene subir la tasa de aciertos de caché antes de discutir un cambio de modelo. Cómo hacerlo: la guía de costos de la caché de prompts.
Latencia: cómo la medimos y cómo reproducirla
Primero, una trampa que conviene señalar: "llegaron las cabeceras de respuesta" y "llegó el primer token de contenido" son dos cosas distintas. Muchos scripts de prueba hacen una única lectura bloqueante de todo el stream y luego calculan el tiempo transcurrido. Si el búfer de lectura es demasiado grande, la lectura se bloquea hasta que el servidor cierra la conexión, y un primer token de 1.5 segundos se convierte en una medición de 58 segundos. Nuestra propia sonda cayó exactamente en esta trampa. Para medir el TTFT hay que detenerse en el primer evento SSE que contenga contenido.
La prueba reproducible más sencilla usa time_starttransfer de curl (cabeceras más primer byte):
curl -s -N -o /dev/null \
  -w "ttfb=%{time_starttransfer}s total=%{time_total}s\n" \
  https://api.hop-base.com/v1/responses \
  -H "Authorization: Bearer sk-your-key" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "gpt-6-astra",
    "input": "Explain vector databases in one sentence",
    "stream": true
  }'
Cambie model por gpt-5.6-sol y vuelva a ejecutarla: misma franja horaria, mismo prompt, con un N de al menos 20 para cada uno. Se comparan distribuciones, no llamadas individuales. En doce muestras en streaming sobre la ruta de producción del 2026-09-05, el primer token de GPT-6 Astra con prompts cortos llegó entre 1.5 y 3.6 segundos, y el nivel 5.6 se midió en el mismo rango. La conclusión: en cargas con streaming, la latencia no es motivo para elegir uno u otro. Lo son el costo y la tasa de éxito de las tareas. Para un método más completo (P95/P99, tasa de cortes del stream, cómo la caché amplifica el TTFT), consulte cómo medir el rendimiento de una API de LLM.
Una nota práctica para el momento actual: prefiera el streaming (stream=true). En este momento, los tiempos de respuesta sin streaming varían mucho del lado del proveedor, y las solicitudes de cola pueden alcanzar los tiempos de espera del borde de la CDN. Las cargas de chat, agentes y Codex ya usan streaming, por lo que no se ven afectadas.
Lista de verificación en tres pasos
- Ponga precio al fallo, no al token. En trabajos donde un fallo cuesta tiempo humano para corregirlo (cambios de código en producción, textos de cara al cliente, extracción estructurada que termina en una base de datos), un modelo más caro se amortiza en cuanto reduce el retrabajo del 20% al 10%. En trabajos donde un fallo solo implica volver a ejecutar, el nivel más barato gana casi siempre.
- Compruebe si se aplica la caché. Prompts de sistema largos, definiciones de herramientas extensas, prefijos compartidos entre varios turnos: los aciertos de caché reducen la diferencia casi a la mitad. Las solicitudes cortas de un solo turno no se benefician de la caché, así que se paga la diferencia completa.
- Después, haga una prueba dividida real. Enrute un porcentaje del tráfico real de producción a cada modelo durante una semana y compare el costo real y la tasa de retrabajo por modelo en los registros de uso de la consola. No deje que el benchmark de otro decida por usted — incluido este.
Acceso y confirmación de disponibilidad
Para saber si GPT-6 Astra está disponible, consulte GET /v1/models con su clave. Tanto el endpoint Responses como Chat Completions funcionan de forma nativa, y en Codex CLI basta con cambiar el nombre del modelo a gpt-6-astra — sin cambios de URL base ni de autenticación.
OpenAI todavía está desplegando GPT-6 por fases, así que la disponibilidad es la que devuelva GET /v1/models para su clave. Compruébelo antes de llamar:
curl https://api.hop-base.com/v1/models \
  -H "Authorization: Bearer sk-your-key" | grep gpt-6
Los detalles del lanzamiento están en el artículo de lanzamiento de GPT-6 Astra; el catálogo completo, en la documentación de referencia de modelos.
Preguntas frecuentes
¿Cuánto más caro es GPT-6 Astra que GPT-5.6?
Con el precio actual de GPT-5.6 Sol: 2.50x en entrada ($10 frente a $4), 2.50x en entrada en caché ($1 frente a $0.40) y 2.50x en salida ($50 frente a $20), todo al precio de lista de OpenAI por millón de tokens. Como las tres relaciones coinciden, una llamada típica también sale a unas 2.5x, sea cual sea su proporción entre entrada y salida; la caché cambia la diferencia absoluta, no la relación.
¿Qué tan distinta es la latencia del primer token?
En muestras con streaming sobre la ruta de producción del 2026-09-05, el primer token de GPT-6 Astra con prompts cortos llegó entre 1.5 y 3.6 segundos, el mismo rango que el nivel 5.6. La latencia no es motivo para elegir entre ellos. Vuelva a ejecutar el curl anterior en su propia región y franja horaria; la distribución importa más que cualquier llamada individual.
¿Cuándo vale la pena cambiar a GPT-6 Astra?
Cuando un solo fallo es costoso y la tarea debe salir bien a la primera: agentes de larga duración, refactorizaciones entre varios archivos, razonamiento y planificación complejos. En cambio, las respuestas cortas de alta frecuencia, la clasificación, la extracción y la reescritura masiva — donde un reintento no cuesta casi nada — siguen ofreciendo mejor relación calidad-precio en el nivel 5.6.
¿Qué tamaño tiene la ventana de contexto?
A la fecha de redacción, OpenAI no ha publicado una ventana de contexto ni una salida máxima oficiales para GPT-6 Astra, y no indicamos cifras que el proveedor no haya confirmado. Considere como referencia los metadatos que devuelve GET /v1/models y sus resultados reales.
¿Cómo confirmar que realmente se llega a GPT-6 y no a un modelo sustituto?
Revise el campo model que se devuelve en el cuerpo de la respuesta y ejecute un conjunto fijo de sondas como comparación lado a lado. El método completo, incluido cómo diseñar preguntas discriminantes, está en la autoverificación de fidelidad de la API.
Para evaluaciones empresariales y pruebas comparativas de selección de modelos, hable con un asesor; los pasos de integración están en la documentación.